Тарас Тріщук · листопад 2026 · Інфографіка | English
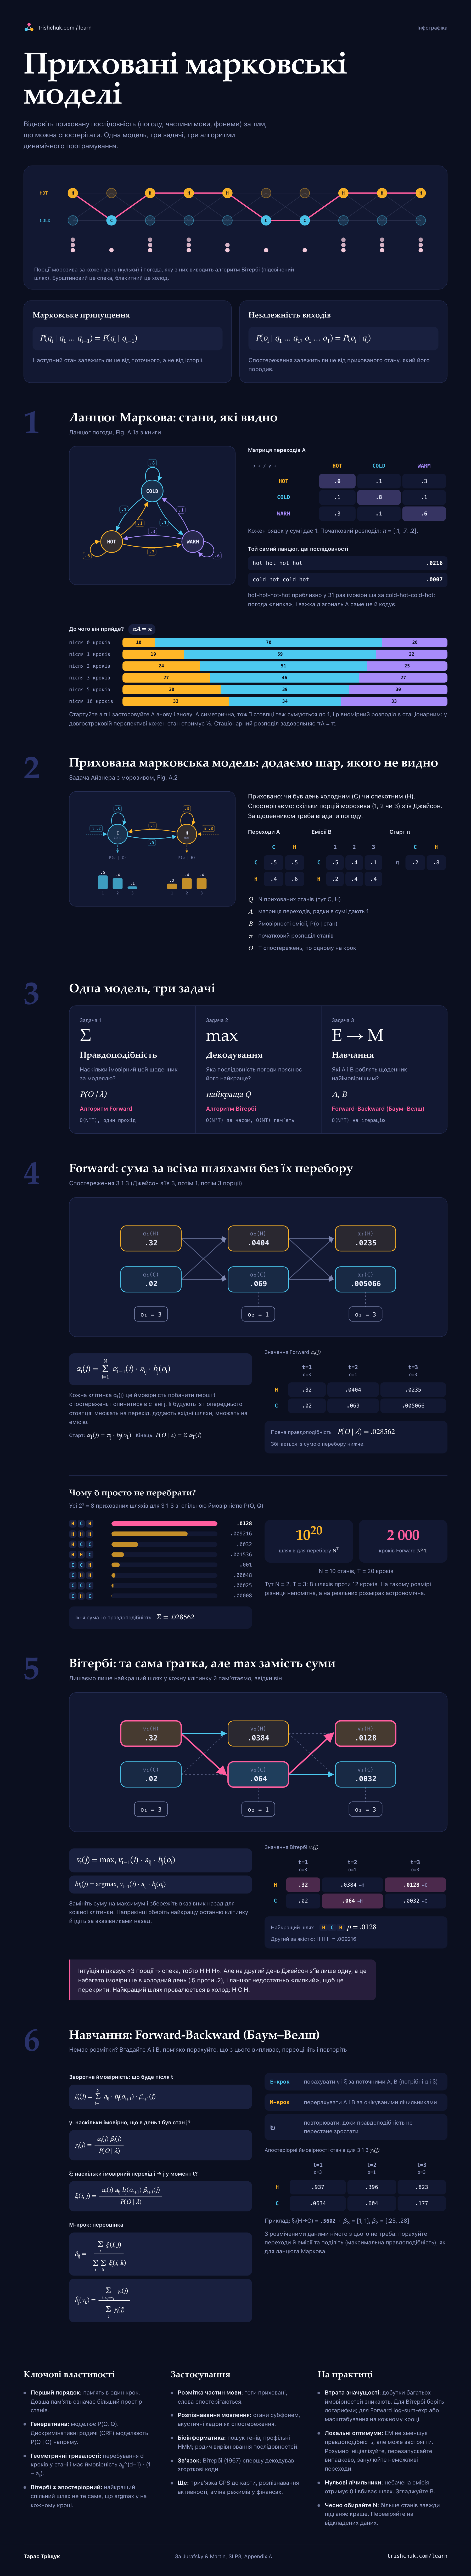
Ви бачите, скільки морозива хтось з’їв, а хочете дізнатися погоду. Прихована марковська модель (HMM) це найменша чесна модель такої ситуації: ланцюг прихованих станів, яких ви не бачите, і кожен із них «випромінює» щось, що бачите. Постер проходить усю історію від ланцюга Маркова до навчання на одному крихітному прикладі, де кожне число можна перевірити вручну.
Усі числа на постері порахував той самий код, що працює в калькуляторі нижче; їх не переписано з рисунка. Приклад і поділ на три задачі взято з Appendix A книги Jurafsky & Martin; коментарі й практичні нотатки мої.
trishchuk.com / learn
Інфографіка
Приховані марковські моделі
Відновіть приховану послідовність (погоду, частини мови, фонеми) за тим, що можна спостерігати. Одна модель, три задачі, три алгоритми динамічного програмування.
Порції морозива за кожен день (кульки) і погода, яку з них виводить алгоритм Вітербі (підсвічений шлях). Бурштиновий це спека, блакитний це холод.
Марковське припущення
P(qi | q1 … qi−1) = P(qi | qi−1)
Наступний стан залежить лише від поточного, а не від історії.
Незалежність виходів
P(oi | q1 … qT, o1 … oT) = P(oi | qi)
Спостереження залежить лише від прихованого стану, який його породив.
1
Ланцюг Маркова: стани, які видно
Ланцюг погоди, Fig. A.1a з книги
Матриця переходів A
з ↓ / у →
HOT
COLD
WARM
HOT
.6
.1
.3
COLD
.1
.8
.1
WARM
.3
.1
.6
Кожен рядок у сумі дає 1. Початковий розподіл: π = [.1, .7, .2].
Той самий ланцюг, дві послідовності
hot hot hot hot.0216
cold hot cold hot.0007
hot-hot-hot-hot приблизно у 31 раз імовірніша за cold-hot-cold-hot: погода «липка», і важка діагональ A саме це й кодує.
До чого він прийде? πA = π
після 0 кроків107020
після 1 кроків195922
після 2 кроків245125
після 3 кроків274627
після 5 кроків303930
після 10 кроків333433
Стартуйте з π і застосовуйте A знову і знову. A симетрична, тож її стовпці теж сумуються до 1, і рівномірний розподіл є стаціонарним: у довгостроковій перспективі кожен стан отримує ⅓. Стаціонарний розподіл задовольняє πA = π.
2
Прихована марковська модель: додаємо шар, якого не видно
Задача Айзнера з морозивом, Fig. A.2
Приховано: чи був день холодним (C) чи спекотним (H). Спостерігаємо: скільки порцій морозива (1, 2 чи 3) з’їв Джейсон. За щоденником треба вгадати погоду.
Переходи A
C
H
C
.5
.5
H
.4
.6
Емісії B
1
2
3
C
.5
.4
.1
H
.2
.4
.4
Старт π
C
H
π
.2
.8
Q
N прихованих станів (тут C, H)
A
матриця переходів, рядки в сумі дають 1
B
ймовірності емісії, P(o | стан)
π
початковий розподіл станів
O
T спостережень, по одному на крок
3
Одна модель, три задачі
Задача 1
Σ
Правдоподібність
Наскільки імовірний цей щоденник за моделлю?
P(O | λ)
Алгоритм Forward
O(N²T), один прохід
Задача 2
max
Декодування
Яка послідовність погоди пояснює його найкраще?
найкраща Q
Алгоритм Вітербі
O(N²T) за часом, O(NT) пам’ять
Задача 3
E → M
Навчання
Які A і B роблять щоденник найімовірнішим?
A, B
Forward-Backward (Баум–Велш)
O(N²T) на ітерацію
4
Forward: сума за всіма шляхами без їх перебору
Спостереження 3 1 3 (Джейсон з’їв 3, потім 1, потім 3 порції)
αt(j) = NΣi=1αt−1(i) · aij · bj(ot)
Кожна клітинка αₜ(j) це ймовірність побачити перші t спостережень і опинитися в стані j. Її будують із попереднього стовпця: множать на перехід, додають вхідні шляхи, множать на емісію.
Повна правдоподібністьP(O | λ) = .028562Збігається із сумою перебору нижче.
Чому б просто не перебрати?
Усі 2³ = 8 прихованих шляхів для 3 1 3 зі спільною ймовірністю P(O, Q)
HCH.0128
HHH.009216
HCC.0032
HHC.001536
CCH.001
CHH.00048
CCC.00025
CHC.00008
Їхня сума і є правдоподібністьΣ = .028562
1020шляхів для перебору NT
2 000кроків Forward N²·T
N = 10 станів, T = 20 кроків
Тут N = 2, T = 3: 8 шляхів проти 12 кроків. На такому розмірі різниця непомітна, а на реальних розмірах астрономічна.
5
Вітербі: та сама ґратка, але max замість суми
Лишаємо лише найкращий шлях у кожну клітинку й пам’ятаємо, звідки він
vt(j) = maxivt−1(i) · aij · bj(ot)
btt(j) = argmaxivt−1(i) · aij · bj(ot)
Замініть суму на максимум і збережіть вказівник назад для кожної клітинки. Наприкінці оберіть найкращу останню клітинку й ідіть за вказівниками назад.
Значення Вітербі vt(j)
t=1 o=3
t=2 o=1
t=3 o=3
H
.32
.0384←H
.0128←C
C
.02
.064←H
.0032←C
Найкращий шляхHCHp = .0128Другий за якістю: H H H = .009216
Інтуїція підказує «3 порції ⇒ спека, тобто H H H». Але на другий день Джейсон з’їв лише одну, а це набагато імовірніше в холодний день (.5 проти .2), і ланцюг недостатньо «липкий», щоб це перекрити. Найкращий шлях провалюється в холод: H C H.
6
Навчання: Forward-Backward (Баум–Велш)
Немає розмітки? Вгадайте A і B, пом’яко порахуйте, що з цього випливає, переоцініть і повторіть
Зворотна ймовірність: що буде після t
βt(i) = NΣj=1aij · bj(ot+1) · βt+1(j)
γ: наскільки імовірно, що в день t був стан j?
γt(j) = αt(j) βt(j) / P(O | λ)
ξ: наскільки імовірний перехід i → j у момент t?
ξt(i, j) = αt(i) aijbj(ot+1) βt+1(j) / P(O | λ)
M-крок: переоцінка
âij = Σtξt(i, j) / ΣtΣkξt(i, k)
b̂j(vk) = Σt: ot=vkγt(j) / Σtγt(j)
E-крокпорахувати γ і ξ за поточними A, B (потрібні α і β)
M-крокперерахувати A і B за очікуваними лічильниками
↻повторювати, доки правдоподібність не перестане зростати
Введіть кількість порцій морозива (1, 2 або 3 на день, до 30 днів) і подивіться, як той самий код Forward і Вітербі з постера обробляє вашу послідовність.
L. R. Rabiner (1989), A tutorial on hidden Markov models and selected applications in speech recognition, Proc. IEEE 77(2). Класичний туторіал.
J. Eisner (2002), An interactive spreadsheet for teaching the forward-backward algorithm. Звідси задача з морозивом.
A. J. Viterbi (1967), Error bounds for convolutional codes and an asymptotically optimum decoding algorithm. L. E. Baum та ін. (1966–72) для алгоритму forward-backward.